
บทนำและที่มาของ Apache Atlas
แนวคิดและที่มาของปัญหา ที่นำไปสู่การพัฒนา Apache Atlas เกิดขึ้นจากความท้าทายในยุค Big Data โดยเฉพาะเมื่อองค์กรต่างๆ เริ่มเปลี่ยนมาใช้งาน Apache Hadoop และระบบ Data Lake กันมากขึ้น ซึ่งทำให้เกิดปัญหาหลักๆ ดังนี้
ภาวะ "Data Swamp" (หนองน้ำข้อมูล) เมื่อการเก็บข้อมูลทำได้ง่ายและถูกลง องค์กรจึงสาดข้อมูลทุกอย่างลง Data Lake จนไม่รู้ว่าใครเอาอะไรมาเก็บไว้บ้าง ข้อมูลไหนเก่า ข้อมูลไหนซ้ำซ้อน จนระบายข้อมูลมาใช้งานไม่ได้ ดังนั้นจึงควรมีระบบที่สามารถระบุ ติดตาม เก็บประวัติการจัดเก็บข้อมูลต่างๆ อย่างเป็นระบบ ระเบียบมากขึ้น
สถาปัตยกรรมข้อมูลที่ซับซ้อนเกินไป ข้อมูลไหลผ่านเครื่องมือหลายตัวมาก เช่น เข้ามาทาง Kafka ถูกประมวลผลด้วย Spark แล้วนำไปเก็บใน Hive จากนั้นส่งต่อไปทำรายงานบน BI พอข้อมูลปลายทางผิดพลาด ทีมงานไม่สามารถไล่เช็กได้เลยว่าข้อมูลพังที่ขั้นตอนไหน ให้ในการตรวจสอบที่มาของข้อมูลที่ผ่านมาของข้อมูลนั้นที่นำไปใช้
กฎหมายและการควบคุมความปลอดภัย (Compliance & Security) การมาของกฎหมายคุ้มครองข้อมูลส่วนบุคคล (เช่น GDPR, PDPA) บังคับให้องค์กรต้องรู้ว่าข้อมูลส่วนบุคคล (PII) เก็บอยู่ที่ไหนบ้าง แต่ระบบ Big Data แบบเดิมไม่มีตัวช่วยค้นหาหรือจัดประเภทข้อมูลเหล่านี้ได้อย่างเป็นระบบ
ต่างคนต่างนิยาม (Lack of Business Context) ทีม Business พูดคำหนึ่ง ทีม Developer เข้าใจอีกคำหนึ่ง เนื่องจากไม่มีระบบพจนานุกรมกลาง (Glossary) ที่เชื่อมคำศัพท์ทางธุรกิจเข้ากับตารางข้อมูลทางเทคนิค เพื่อสร้างความเข้าใจให้ตรงกัน การสื่อสารที่ถูกต้อง เป็นตัวกลางที่ประสานทุกภาคส่วน
Timeline ของ Apache Altals
ปี 2015 (เริ่มต้นพัฒนา) โครงการนี้ถูกประกาศเปิดตัวครั้งแรกโดยบริษัท Hortonworks โดยมีเป้าหมายเพื่อตอบโจทย์ความต้องการด้าน Data Governance และความปลอดภัยในระบบนิเวศของ Hadoop หลังจากนั้นได้เข้าสู่สถานะโครงการบ่มเพาะของ Apache (Apache Incubator) ในเดือนพฤษภาคม 2015 และได้ปล่อยเวอร์ชันแรกสุด (0.5.0-incubating) ออกมาในเดือนกรกฎาคมปีเดียวกัน
ปี 2017 (เลื่อนขั้นเป็นโครงการหลัก) หลังจากอยู่ในช่วงบ่มเพาะและพัฒนาเครื่องมืออยู่ประมาณ 2 ปี Apache Atlas ก็ประสบความสำเร็จและได้รับการจบการศึกษาเลื่อนขั้นขึ้นเป็นโครงการระดับบนสุด (Top-Level Project) ของ Apache Software Foundation อย่างเต็มตัวในเดือนมิถุนายน 2017
ปี 2018 (เวอร์ชัน 1.0.0) ตัวระบบได้พัฒนาจนเสถียรและปล่อยเวอร์ชัน Atlas 1.0.0 ออกมาอย่างเป็นทางการในเดือนมิถุนายน 2018 ซึ่งถือเป็นเวอร์ชันหลักเวอร์ชันแรกที่องค์กรต่าง ๆ นำไปใช้ในระดับ Production กันอย่างแพร่หลาย
Apache Atlas คืออะไร
Apache Atlas คือ โอเพนซอร์สเฟรมเวิร์กสำหรับ Data Governance (การกำกับดูแลข้อมูล) และ Metadata Management (การจัดการเมตาเดต้า) โดยเฉพาะในระบบ Apache Hadoop และระบบนิเวศข้อมูลขององค์กร
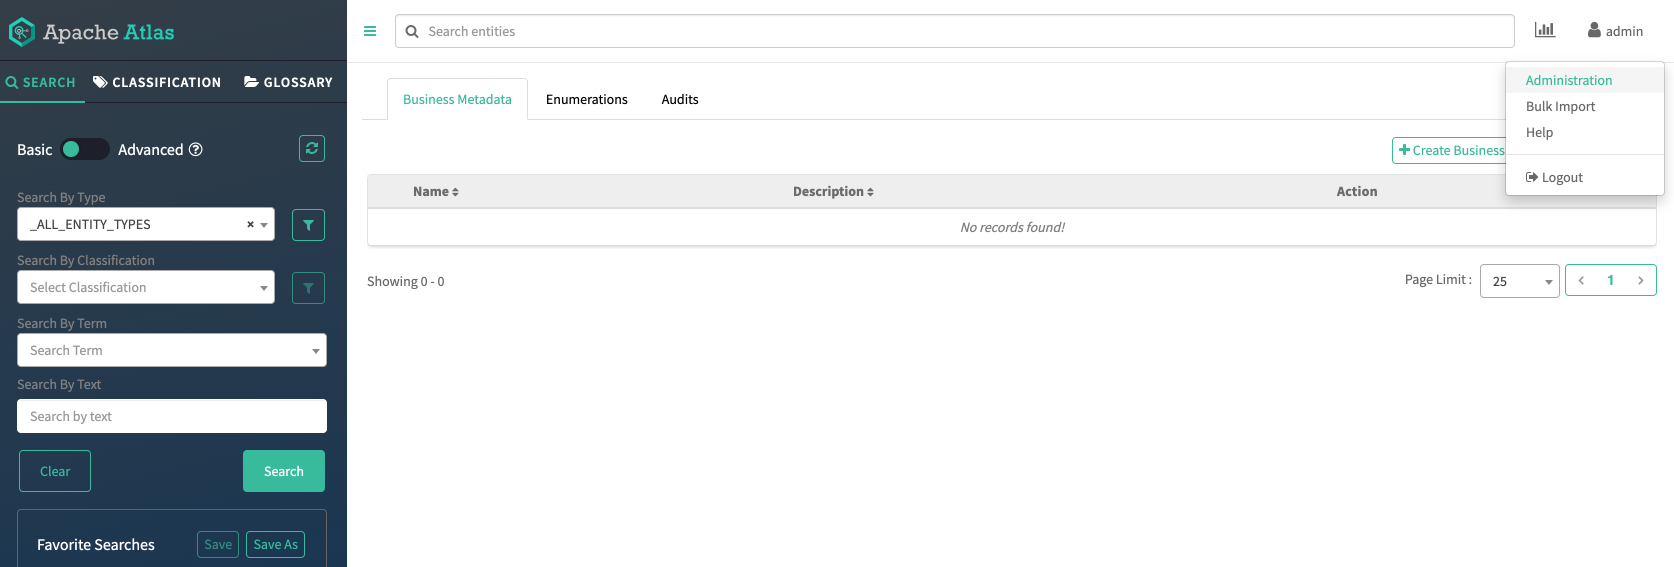
Apache Atlas ทำอะไรได้บ้าง ?
- สร้างแคตตาล็อกข้อมูล (Data Catalog): รวบรวมและจัดทำสารบัญทรัพย์สินข้อมูล (Data Assets) ทั้งหมดในองค์กรว่ามีอะไร อยู่ที่ไหน
- ติดตามที่มา/ลำดับข้อมูล (Data Lineage): แสดงภาพกราฟว่าข้อมูลมาจากไหน ผ่านกระบวนการแปลง (Transformation) อะไร และไหลไปใช้ที่ไหนต่อ (เช่น จาก Hive Table ตัวนี้ ถูกแปลงไปสรุปในรายงานไหน)
- จำแนกประเภทข้อมูล (Classification): จัดกลุ่มข้อมูลตามความสำคัญหรือความลับ (เช่น PII, ข้อมูลส่วนบุคคล, ความลับทางการค้า)
- กำหนดนโยบายและความปลอดภัย (Policy Enforcement & Masking): ควบคุมการเข้าถึงหรือซ่อนข้อมูลตามประเภทที่จัดไว้
- สร้างคำศัพท์ทางธุรกิจ (Business Glossary): เชื่อมโยงคำศัพท์ทางธุรกิจเข้ากับชุดข้อมูลทางเทคนิคเพื่อให้ทีมธุรกิจและไอทีเข้าใจตรงกัน
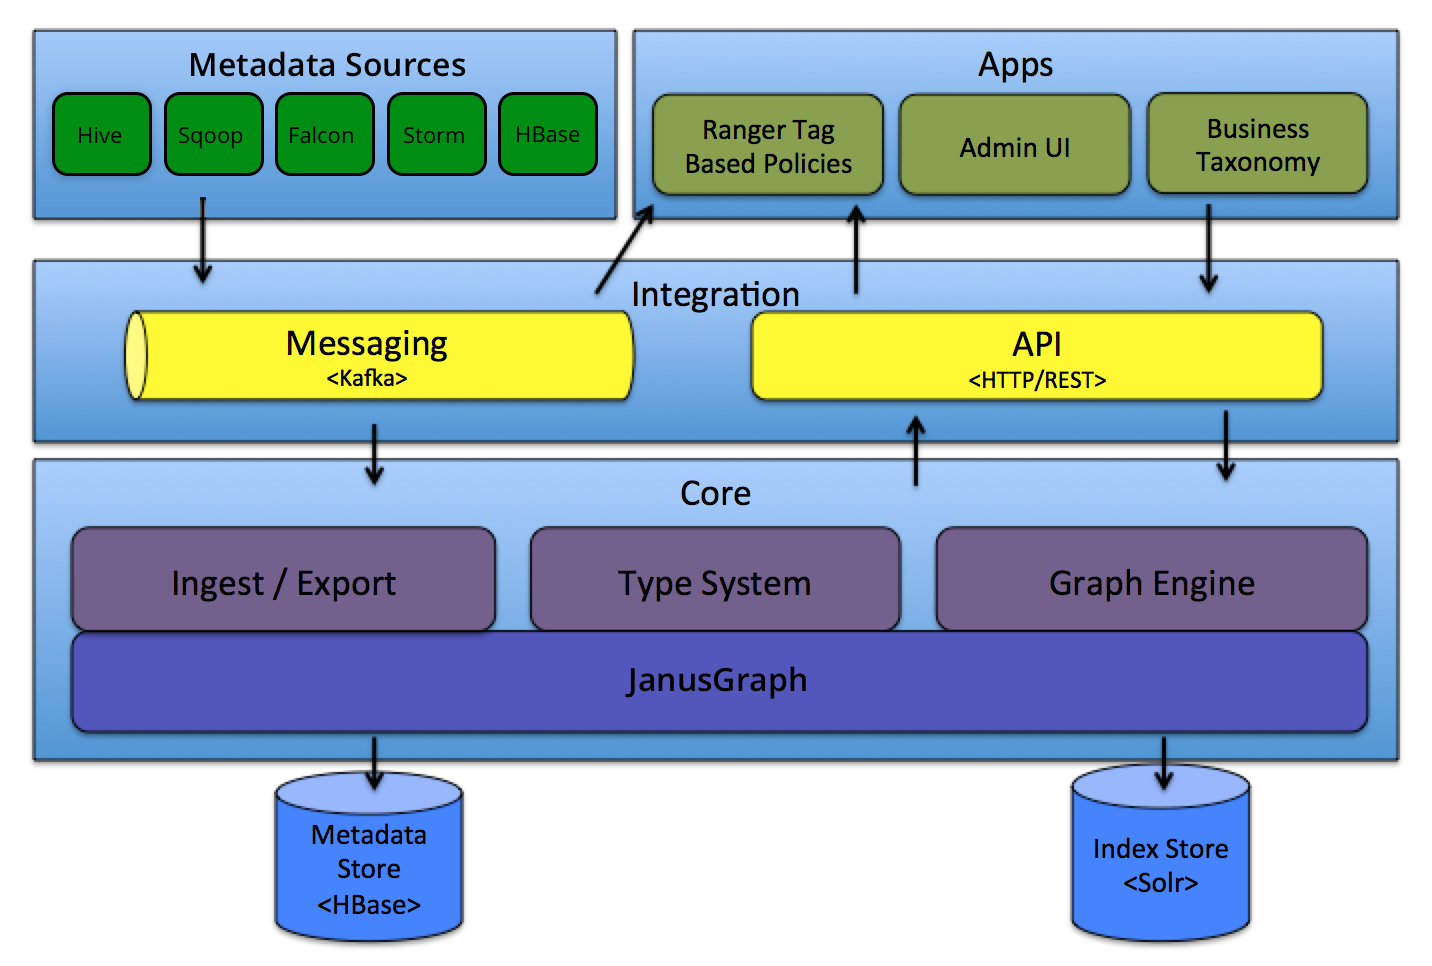
แนวคิดการเกิดขึ้นของ Apache Atlas
Apache Atlas ถูกออกแบบภายใต้แนวคิด "ศูนย์กลางการควบคุมและทำความเข้าใจข้อมูล" (Centralized Data Governance) โดยเปลี่ยนวิธีจัดการข้อมูลดังนี้- อัตโนมัติ (Automated) เปลี่ยนจากการจดบันทึกด้วยมือให้เป็นการเก็บอัตโนมัติ (Automated Metadata) โดยฝังตัวเชื่อมต่อ (Hooks/Plugins) ไว้กับเครื่องมือ Big Data ต่างๆ (เช่น Hive, Storm, Falcon, Kafka) เพื่อดึงโครงสร้างข้อมูล (Metadata) ออกมาโดยอัตโนมัติเมื่อมีการสร้างหรือแก้ไขตาราง
- เครือข่ายความสัมพันธ์ (Graph-Based Modeling) มองข้อมูลเป็นเครือข่ายความสัมพันธ์แบบกราฟ โดยใช้แนวคิด Graph Engine ในการเก็บข้อมูล เพื่อให้สามารถลากเส้นความสัมพันธ์ต่อกันเป็นทอดๆ ได้ชัดเจนยิ่งขึ้น เป็นหัวใจสำคัญหลักของการทำ Data Lineage เพื่อการติดตามที่มาของข้อมูลแต่ละเส้นได้ง่าย
- แยกประเภทข้อมูล (Data Classification ) เพื่อการขับเคลื่อนนโยบาย (Classification-Driven Security) ที่มีแนวคิดจัดกลุ่มข้อมูลแบบติดแท็ก (Tagging) เช่น แท็กว่า EXPIRED_DATA หรือ PII_SENSITIVE เพื่อส่งต่อแท็กนี้ไปให้ระบบรักษาความปลอดภัยอย่าง Apache Ranger ทำการซ่อนหรือบล็อกการเข้าถึงได้ทันที
- เปิดกว้างและขยายระบบได้ง่าย (Extensible Type System) โดยไม่มีขีดจำกัดว่าจะต้องใช้กับ Hadoop อย่างเดียว เท่านั้น แต่เปิดให้ผู้ใช้งานสามารถออกแบบโครงสร้างข้อมูล (Type) ใหม่ๆ ขึ้นมาเองได้ เพื่อรองรับเทคโนโลยีที่จะเกิดขึ้นในอนาคต
ความคิดเห็น
แสดงความคิดเห็น